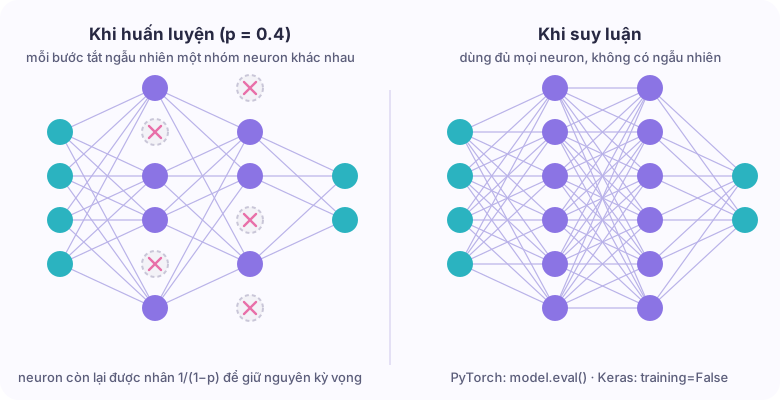
Dropout là kỹ thuật regularization cho mạng neural: trong lúc huấn luyện, mỗi neuron (thường ở các tầng ẩn) bị tắt ngẫu nhiên với xác suất $p$, tức đầu ra của nó bị đặt bằng 0 trong bước huấn luyện đó. Vì không neuron nào được “đảm bảo” có mặt, mạng phải học các đặc trưng bền vững hơn thay vì dựa dẫm vào vài neuron cụ thể, nhờ đó giảm overfitting. Khi suy luận (inference), dropout được tắt và mạng dùng đầy đủ mọi neuron.
Cập nhật 11/2026: bài viết năm 2019 được viết lại: làm rõ cơ chế inverted dropout, sửa cách giải thích pha test, thêm code PyTorch và Keras đã chạy thử, một thí nghiệm mới có số liệu, và các biến thể như Spatial Dropout, DropBlock, MC Dropout. Thực nghiệm CIFAR-10 năm 2019 vẫn được giữ lại ở cuối bài.
Code và số liệu trong bài chạy với Python 3.13, NumPy 2.5, PyTorch 2.15 (CPU), Keras 3.15 (backend PyTorch) và scikit-learn 1.9.
Tóm tắt nhanh
- Khi huấn luyện: mỗi phần tử bị đặt về 0 với xác suất $p$; các phần tử còn lại được nhân với $1/(1-p)$.
- Khi suy luận: dropout không làm gì cả, đầu vào đi thẳng qua.
- $p$ trong PyTorch và
ratetrong Keras là xác suất bỏ, không phải xác suất giữ. - Giá trị hay dùng: 0,5 cho tầng fully connected lớn, 0,1–0,2 gần đầu vào, khoảng 0,1 trong Transformer. Luôn chỉnh lại trên tập validation.
- Lỗi kinh điển: quên gọi
model.eval()trước khi đánh giá trong PyTorch, khiến kết quả dự đoán ngẫu nhiên mỗi lần chạy.
Overfitting và hiện tượng “co-adaptation”
Một mạng nhiều tham số có thể thuộc lòng tập huấn luyện: loss trên train giảm gần về 0 nhưng loss trên dữ liệu mới lại tăng. Đó là overfitting.
Hinton và cộng sự (2012) mô tả một nguyên nhân cụ thể trong mạng neural là co-adaptation: các neuron học cách “sửa lỗi cho nhau” theo những kiểu chỉ đúng trên dữ liệu huấn luyện. Một neuron có thể chỉ hữu ích khi đi kèm vài neuron khác. Dropout phá vỡ sự phụ thuộc này: vì bạn đồng hành có thể biến mất bất cứ lúc nào, mỗi neuron buộc phải học một đặc trưng tự nó có ích.
Trước dropout, cách chống overfitting quen thuộc là thêm phạt L1 hoặc L2 vào hàm loss (như trong Logistic Regression). Dropout là một cách regularization khác, tác động trực tiếp lên cấu trúc mạng trong lúc huấn luyện, và có thể dùng cùng với L2 hay weight decay.
Dropout hoạt động thế nào?
Với đầu ra $h_j$ của neuron thứ $j$ ở một tầng, mỗi bước huấn luyện lấy một mặt nạ ngẫu nhiên $m_j$:
$$ m_j \sim \text{Bernoulli}(1-p), \qquad \tilde{h}_j = \frac{m_j \, h_j}{1-p} $$Nghĩa là neuron được giữ với xác suất $1-p$ và bị tắt với xác suất $p$. Mặt nạ được lấy lại ở mỗi bước và cho từng mẫu trong batch, nên mỗi lần cập nhật thực chất huấn luyện một mạng con “mỏng” khác nhau. Ở bước backward, gradient cũng chỉ chảy qua các neuron được giữ.
Khi suy luận, $\tilde{h}_j = h_j$: không có mặt nạ, không có ngẫu nhiên.
Vì sao phải nhân với 1/(1−p)?
Nếu chỉ tắt neuron mà không bù lại, tổng tín hiệu đi vào tầng sau khi huấn luyện sẽ nhỏ hơn lúc suy luận (vì lúc suy luận có đủ neuron). Nhân phần còn lại với $1/(1-p)$ giữ nguyên kỳ vọng:
$$ \mathbb{E}\big[\tilde{h}_j\big] = (1-p) \cdot \frac{h_j}{1-p} + p \cdot 0 = h_j $$Cách làm này gọi là inverted dropout và là cách PyTorch, Keras đang dùng. Bài báo gốc của Srivastava và cộng sự (2014) làm ngược lại: không nhân gì khi huấn luyện, nhưng khi test thì nhân trọng số đi ra từ mỗi neuron với xác suất giữ. Hai cách cho cùng kỳ vọng; inverted dropout tiện hơn vì mã suy luận không phải thay đổi gì. (Bản năm 2019 của bài này mô tả theo cách của bài báo gốc, “giảm activation ở pha test”; với các framework hiện nay, việc đó đã được làm sẵn ngay trong lúc huấn luyện.)
p là xác suất bỏ hay xác suất giữ?
Đây là chỗ dễ nhầm nhất khi đọc tài liệu:
| Nguồn | Ký hiệu | Ý nghĩa | Dropout “một nửa” |
|---|---|---|---|
| Bài báo Srivastava và cộng sự (2014) | $p$ | xác suất giữ | $p = 0{,}5$ |
| TensorFlow 1.x | keep_prob |
xác suất giữ | keep_prob=0.5 |
PyTorch nn.Dropout |
p |
xác suất bỏ | p=0.5 |
Keras layers.Dropout |
rate |
xác suất bỏ | rate=0.5 |
Khi chuyển code cũ dùng keep_prob=0.8 sang PyTorch, giá trị đúng là p=0.2, không phải p=0.8.
Vì sao dropout giúp chống overfitting?
Có ba cách nhìn bổ sung cho nhau:
- Ensemble rất nhiều mạng con. Một mạng có $n$ neuron có thể bị tắt sinh ra tới $2^n$ mạng con khác nhau, tất cả dùng chung trọng số. Huấn luyện với dropout gần giống huấn luyện cả “tập thể” này, và khi suy luận, mạng đầy đủ (đã scale) xấp xỉ việc lấy trung bình dự đoán của chúng (Srivastava và cộng sự, 2014; Baldi và Sadowski, 2013 phân tích tính chất lấy trung bình này).
- Chống co-adaptation. Như ở trên, neuron không thể trông cậy vào một vài “đồng đội” cố định.
- Thêm nhiễu vào quá trình học. Nhiễu nhân tính làm mô hình khó khớp chính xác từng điểm dữ liệu, tương tự cách data augmentation hay batch nhỏ có tác dụng regularization.
Cái giá phải trả là huấn luyện chậm hội tụ hơn: loss trên train giảm chậm hơn và thường cần nhiều epoch hơn.
Tự cài đặt dropout bằng NumPy
Viết tay một lần là cách nhanh nhất để hiểu chuyện gì xảy ra bên trong:
 1import numpy as np
 2
 3def dropout_forward(x, p, training=True, rng=np.random.default_rng(0)):
 4    """Inverted dropout: p là xác suất BỎ một phần tử (giống PyTorch/Keras)."""
 5    if not training or p == 0.0:
 6        return x, None
 7    mask = (rng.random(x.shape) >= p) / (1.0 - p)   # giữ lại với xác suất 1-p rồi nhân 1/(1-p)
 8    return x * mask, mask
 9
10def dropout_backward(grad_out, mask):
11    return grad_out * mask   # gradient chỉ chảy qua các neuron được giữ
12
13x = np.ones((1, 10))
14out, mask = dropout_forward(x, p=0.5)
15print("train:", out.round(2))
16print("eval :", dropout_forward(x, p=0.5, training=False)[0])
17
18big = np.ones((10_000, 100))
19out, _ = dropout_forward(big, p=0.3)
20print("tỉ lệ phần tử bị bỏ:", round(float((out == 0).mean()), 3))
21print("trung bình đầu ra:", round(float(out.mean()), 3), "(kỳ vọng vẫn = 1.0)")
1train: [[2. 0. 0. 0. 2. 2. 2. 2. 2. 2.]]
2eval : [[1. 1. 1. 1. 1. 1. 1. 1. 1. 1.]]
3tỉ lệ phần tử bị bỏ: 0.3
4trung bình đầu ra: 1.0 (kỳ vọng vẫn = 1.0)
Với $p = 0{,}5$, phần tử được giữ có giá trị 2 (nhân với $1/(1-0{,}5)$). Trên một mảng lớn, khoảng 30% phần tử bị bỏ nhưng trung bình đầu ra vẫn bằng 1, đúng như công thức kỳ vọng ở trên.
Dropout trong PyTorch
nn.Dropout(p) tự đổi hành vi theo chế độ của module: bật khi model.train(), thành phép đồng nhất khi model.eval().
 1import torch
 2from torch import nn
 3
 4torch.manual_seed(0)
 5layer = nn.Dropout(p=0.5)
 6x = torch.ones(1, 8)
 7
 8layer.train()
 9print("model.train():", layer(x))
10layer.eval()
11print("model.eval(): ", layer(x))
1model.train(): tensor([[0., 0., 2., 0., 0., 0., 2., 2.]])
2model.eval():  tensor([[1., 1., 1., 1., 1., 1., 1., 1.]])
Trong một mô hình thật, dropout thường đặt sau hàm kích hoạt của các tầng ẩn:
 1import torch
 2from torch import nn
 3
 4model = nn.Sequential(
 5    nn.Linear(784, 256), nn.ReLU(), nn.Dropout(0.3),
 6    nn.Linear(256, 128), nn.ReLU(), nn.Dropout(0.3),
 7    nn.Linear(128, 10),           # không đặt dropout ở tầng đầu ra
 8)
 9
10model.train()                     # trước vòng lặp huấn luyện: dropout bật
11logits = model(torch.randn(32, 784))
12
13model.eval()                      # trước khi đánh giá hoặc dự đoán: dropout tắt
14with torch.no_grad():
15    preds = model(torch.randn(4, 784)).argmax(dim=1)
16print(logits.shape, preds.shape)
Nếu viết forward bằng hàm torch.nn.functional.dropout, nhớ truyền training=self.training; mặc định của hàm là training=True, nên quên tham số này sẽ khiến dropout vẫn chạy cả khi suy luận.
Dropout trong Keras
Trong Keras, tham số là rate (xác suất bỏ). model.fit tự bật dropout, còn model.predict và model.evaluate tự tắt. Khi gọi layer trực tiếp, bạn điều khiển bằng training:
 1import os
 2os.environ.setdefault("KERAS_BACKEND", "torch")
 3import numpy as np
 4import keras
 5from keras import layers
 6
 7x = np.ones((1, 8), dtype="float32")
 8drop = layers.Dropout(rate=0.5, seed=42)
 9print("training=True :", keras.ops.convert_to_numpy(drop(x, training=True)))
10print("training=False:", keras.ops.convert_to_numpy(drop(x, training=False)))
11
12model = keras.Sequential([
13    keras.Input(shape=(784,)),
14    layers.Dense(256, activation="relu"),
15    layers.Dropout(0.3),
16    layers.Dense(128, activation="relu"),
17    layers.Dropout(0.3),
18    layers.Dense(10, activation="softmax"),
19])
20model.summary()
1training=True : [[0. 0. 2. 0. 2. 0. 2. 0.]]
2training=False: [[1. 1. 1. 1. 1. 1. 1. 1.]]
Lớp Dropout không có tham số học được, nên trong model.summary() cột Param # của nó luôn bằng 0.
Thí nghiệm: dropout trên dữ liệu ít và nhiễu
Dropout phát huy rõ nhất khi mô hình lớn hơn nhiều so với lượng dữ liệu. Mình dựng tình huống đó: chỉ 200 điểm của bài toán hai nửa mặt trăng (make_moons) với nhiễu 0,35, một mạng hai tầng ẩn 512 neuron, huấn luyện 2.000 epoch bằng Adam, rồi đo accuracy trên 5.000 điểm mới. Mỗi mức dropout chạy 3 seed:
 1import torch
 2from torch import nn
 3from sklearn.datasets import make_moons
 4
 5torch.set_num_threads(1)
 6X_tr, y_tr = make_moons(n_samples=200, noise=0.35, random_state=0)
 7X_va, y_va = make_moons(n_samples=5000, noise=0.35, random_state=1)
 8X_tr, X_va = torch.tensor(X_tr, dtype=torch.float32), torch.tensor(X_va, dtype=torch.float32)
 9y_tr, y_va = torch.tensor(y_tr, dtype=torch.float32), torch.tensor(y_va, dtype=torch.float32)
10
11def make_model(p):
12    return nn.Sequential(
13        nn.Linear(2, 512), nn.ReLU(), nn.Dropout(p),
14        nn.Linear(512, 512), nn.ReLU(), nn.Dropout(p),
15        nn.Linear(512, 1),
16    )
17
18def accuracy(model, X, y):
19    model.eval()                                   # tắt dropout khi đánh giá
20    with torch.no_grad():
21        return ((model(X).squeeze(1) > 0).float() == y).float().mean().item()
22
23def run(p, seed, epochs=2000):
24    torch.manual_seed(seed)
25    model = make_model(p)
26    opt = torch.optim.Adam(model.parameters(), lr=1e-3)
27    for _ in range(epochs):                        # full-batch: 1 epoch = 1 iteration
28        model.train()                              # bật dropout khi huấn luyện
29        loss = nn.functional.binary_cross_entropy_with_logits(model(X_tr).squeeze(1), y_tr)
30        opt.zero_grad()
31        loss.backward()
32        opt.step()
33    return accuracy(model, X_tr, y_tr), accuracy(model, X_va, y_va)
34
35print(f"{'dropout p':>9} {'acc train':>9} {'acc test':>9}")
36for p in [0.0, 0.2, 0.5, 0.8]:
37    rs = [run(p, s) for s in range(3)]
38    print(f"{p:>9.1f} {sum(r[0] for r in rs)/3:>9.3f} {sum(r[1] for r in rs)/3:>9.3f}")
| Dropout $p$ | Accuracy train | Accuracy test | Khoảng cách |
|---|---|---|---|
| 0,0 | 1,000 | 0,842 | 0,158 |
| 0,2 | 0,978 | 0,845 | 0,133 |
| 0,5 | 0,942 | 0,863 | 0,079 |
| 0,8 | 0,895 | 0,878 | 0,017 |
Không có dropout, mạng thuộc lòng 100% điểm huấn luyện (kể cả các điểm nhiễu) nhưng chỉ đúng 84,2% trên dữ liệu mới. Tăng dropout làm accuracy train giảm và accuracy test tăng, khoảng cách giữa hai con số thu hẹp từ 15,8 xuống 1,7 điểm phần trăm. Mức 0,8 tốt nhất ở đây vì mạng rất lớn so với 200 điểm dữ liệu; với mạng nhỏ hơn hoặc nhiều dữ liệu hơn, mức tối ưu sẽ thấp hơn. Toàn bộ thí nghiệm chạy khoảng 5 phút trên CPU 2 nhân.
Một quan sát khác khi mình thử trên bộ chữ số digits của scikit-learn (300 ảnh huấn luyện, mạng 512–512): accuracy validation gần như không đổi (0,941–0,942 ở mọi mức dropout), nhưng validation loss giảm từ 0,320 xuống 0,233 với $p = 0{,}8$. Nghĩa là dropout không phải lúc nào cũng tăng accuracy, nhưng thường làm mô hình bớt “tự tin quá mức” vào các dự đoán sai.
Nên chọn tỉ lệ dropout bao nhiêu?
- Tầng fully connected lớn: 0,5 là điểm xuất phát kinh điển. Srivastava và cộng sự (2014) nhận xét xác suất giữ 0,5 “gần tối ưu cho nhiều loại mạng và bài toán”.
- Gần đầu vào: nhỏ hơn nhiều, khoảng 0,1–0,2 (bài báo gốc: xác suất giữ ở tầng đầu vào nên gần 1 hơn là 0,5).
- Tầng tích chập: dropout từng phần tử ít hiệu quả vì các pixel lân cận tương quan mạnh. Dùng tỉ lệ thấp, hoặc bỏ nguyên cả feature map với
nn.Dropout2d/SpatialDropout2D. - Transformer: bài báo Attention Is All You Need dùng dropout 0,1 cho mô hình cơ sở; đây là mức khởi đầu phổ biến cho các mô hình kiểu Transformer.
- Mô hình lớn hơn hoặc dữ liệu ít hơn thì tăng dropout; dữ liệu rất nhiều thì giảm, thậm chí bỏ.
Dù chọn gì, hãy coi dropout là một siêu tham số và so sánh 2–3 giá trị trên tập validation.
Đặt dropout ở đâu trong mạng?
- Sau hàm kích hoạt của tầng ẩn, như các ví dụ ở trên. Không đặt ở tầng đầu ra.
- Cẩn thận khi dùng chung với Batch Normalization. Li và cộng sự (2018) chỉ ra dropout làm thay đổi phương sai của tín hiệu giữa lúc huấn luyện và lúc suy luận, trong khi BatchNorm lại “ghi nhớ” phương sai lúc huấn luyện, gây ra hiện tượng variance shift làm kết quả kém đi. Cách xử lý phổ biến: đặt dropout sau tất cả các tầng BatchNorm (ví dụ chỉ trước tầng phân loại cuối), hoặc chỉ dùng một trong hai.
- Mạng CNN hiện đại thường dựa nhiều vào BatchNorm, data augmentation và weight decay, chỉ giữ dropout ở phần đầu phân loại. Từ năm 2012, AlexNet đã dùng dropout ở các tầng fully connected để giảm overfitting (xem bài Tìm hiểu mạng AlexNet).
Các biến thể của dropout
| Biến thể | Bỏ cái gì | Dùng khi |
|---|---|---|
| DropConnect (Wan và cộng sự, 2013) | từng trọng số thay vì từng neuron | nghiên cứu, tầng fully connected |
Spatial Dropout / Dropout2d (Tompson và cộng sự, 2014) |
nguyên feature map | tầng tích chập |
| DropBlock (Ghiasi và cộng sự, 2018) | một vùng liên tục trên feature map | CNN cho ảnh |
| Stochastic Depth / DropPath (Huang và cộng sự, 2016) | nguyên khối residual | ResNet, Vision Transformer |
| MC Dropout (Gal và Ghahramani, 2016) | giữ dropout cả khi suy luận, chạy nhiều lần | ước lượng độ bất định của dự đoán |
MC Dropout là trường hợp duy nhất trong bảng cố ý bật dropout lúc suy luận: chạy cùng một đầu vào nhiều lần, độ phân tán của các kết quả cho biết mô hình chắc chắn đến đâu.
Những lỗi thường gặp
- Quên
model.eval()khi đánh giá trong PyTorch: accuracy dao động mỗi lần chạy và thấp hơn thực tế. - Gọi
F.dropoutmà không truyềntraining=self.training, nên dropout chạy cả khi suy luận. - Nhầm
keep_probvớipkhi chuyển code TensorFlow cũ sang PyTorch. - Dropout quá cao cho mạng nhỏ, khiến mô hình bị underfitting (accuracy train cũng thấp).
- Đặt dropout ngay trước BatchNorm gây variance shift như đã nói ở trên.
- Kết luận dropout “không có tác dụng” sau quá ít epoch. Mạng có dropout hội tụ chậm hơn, cần cho nó đủ thời gian.
Thực nghiệm năm 2019 trên CIFAR-10
Ở bản đầu tiên của bài này (2019), mình thử một mạng tích chập nhỏ trên CIFAR-10 (50.000 ảnh huấn luyện, 10.000 ảnh test, 10 lớp) bằng Keras: ba tầng tích chập 64–128–256 kênh, một tầng fully connected 512, đặt dropout sau mọi tầng tích chập và cho tỉ lệ chạy từ 0,0 đến 0,9, mỗi cấu hình huấn luyện 20 epoch với SGD.
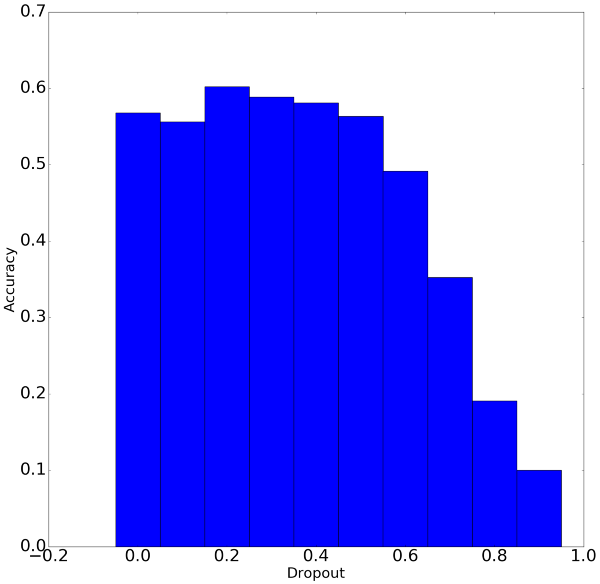
Kết quả khi đó: tỉ lệ 0,2 cho accuracy test tốt nhất, khoảng 0–0,5 chấp nhận được, còn trên 0,5 thì kết quả kém hẳn. Nhìn lại với kinh nghiệm hiện tại, thí nghiệm có vài điểm yếu nên chỉ nên xem là tham khảo: bước chuẩn hóa dữ liệu lấy nhầm trục kênh (dữ liệu dạng (N, H, W, C) nhưng code chuẩn hóa theo trục thứ hai), dropout từng phần tử được đặt ngay sau tầng tích chập (nơi SpatialDropout2D phù hợp hơn), và 20 epoch là chưa đủ để mạng có dropout hội tụ. Dù vậy, kết luận “dropout vừa phải giúp ích, dropout quá cao làm hại” vẫn khớp với thí nghiệm mới ở trên.
Câu hỏi thường gặp
Dropout là gì? Là kỹ thuật tắt ngẫu nhiên một phần neuron trong lúc huấn luyện để mạng không phụ thuộc vào vài neuron cụ thể, nhờ đó giảm overfitting.
Dropout có dùng khi test hoặc khi chạy thật không? Không. Khi suy luận, dropout là phép đồng nhất. Ngoại lệ là MC Dropout, cố ý bật dropout để ước lượng độ bất định.
Dropout rate bao nhiêu là tốt? Bắt đầu với 0,5 cho tầng fully connected lớn, 0,1–0,2 gần đầu vào và khoảng 0,1 cho Transformer, rồi chỉnh trên tập validation.
Dropout và Batch Normalization có dùng chung được không? Được, nhưng nên đặt dropout sau các tầng BatchNorm (ví dụ ngay trước tầng phân loại) để tránh variance shift.
Vì sao accuracy train thấp hơn validation khi dùng dropout? Vì accuracy train hiển thị trong lúc huấn luyện được đo khi dropout đang bật (mạng đang bị tắt bớt neuron), còn validation được đo trên mạng đầy đủ. Đây là hiện tượng bình thường.
Đọc thêm trên blog
- Toàn bộ chủ đề: Nền tảng Machine Learning & Deep Learning
- Epoch, Batch size và Iteration là gì?
- Các thuật toán tối ưu Gradient Descent: SGD, Momentum, RMSprop, Adam, AdamW
- Các kỹ thuật chuẩn hóa trong Deep Learning
- Hai khái niệm quan trọng giúp tăng độ chính xác của các mô hình machine learning
- Một số mẹo khi huấn luyện mạng deep neural network
Tài liệu tham khảo
- Nitish Srivastava, Geoffrey Hinton, Alex Krizhevsky, Ilya Sutskever, Ruslan Salakhutdinov (2014). Dropout: A Simple Way to Prevent Neural Networks from Overfitting. JMLR 15. jmlr.org
- Geoffrey E. Hinton và cộng sự (2012). Improving neural networks by preventing co-adaptation of feature detectors. arXiv:1207.0580
- Pierre Baldi, Peter J. Sadowski (2013). Understanding Dropout. NIPS 26. proceedings.neurips.cc
- Xiang Li, Shuo Chen, Xiaolin Hu, Jian Yang (2018). Understanding the Disharmony between Dropout and Batch Normalization by Variance Shift. arXiv:1801.05134
- Alex Krizhevsky, Ilya Sutskever, Geoffrey E. Hinton (2012). ImageNet Classification with Deep Convolutional Neural Networks. NIPS 25. papers.nips.cc
- Ashish Vaswani và cộng sự (2017). Attention Is All You Need. arXiv:1706.03762
- Li Wan và cộng sự (2013). Regularization of Neural Networks using DropConnect. ICML. proceedings.mlr.press
- Jonathan Tompson và cộng sự (2014). Efficient Object Localization Using Convolutional Networks. arXiv:1411.4280
- Golnaz Ghiasi, Tsung-Yi Lin, Quoc V. Le (2018). DropBlock: A regularization method for convolutional networks. arXiv:1810.12890
- Gao Huang và cộng sự (2016). Deep Networks with Stochastic Depth. arXiv:1603.09382
- Yarin Gal, Zoubin Ghahramani (2016). Dropout as a Bayesian Approximation: Representing Model Uncertainty in Deep Learning. arXiv:1506.02142
- PyTorch. torch.nn.Dropout. docs.pytorch.org
- Keras. Dropout layer và SpatialDropout2D layer. keras.io, keras.io
Bình luận