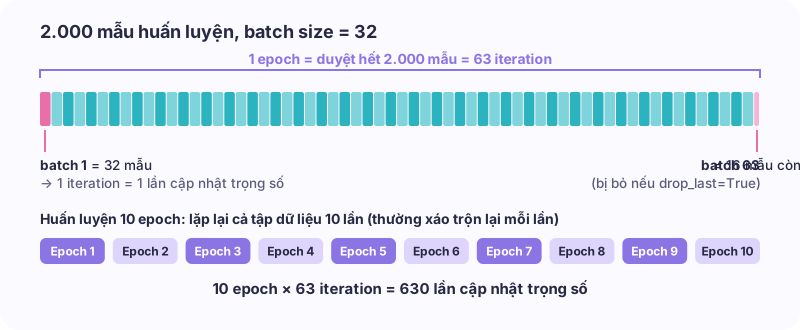
Epoch là một lượt mô hình được “xem” toàn bộ dữ liệu huấn luyện. Batch size là số mẫu đưa vào mô hình trước mỗi lần cập nhật trọng số. Iteration (nhiều thư viện gọi là step) là một lần cập nhật như vậy. Với 2.000 mẫu và batch size 32, mỗi epoch có 63 iteration; huấn luyện 10 epoch nghĩa là trọng số được cập nhật 630 lần.
Ba thuật ngữ này xuất hiện trong mọi dòng log huấn luyện nhưng rất dễ bị dùng lẫn. Bài viết giải thích chúng bằng một ví dụ đời thường, công thức tính, code PyTorch và Keras chạy được, một thí nghiệm nhỏ về ảnh hưởng của batch size, và những chỗ hay nhầm khi đọc log Hugging Face hoặc khi train LoRA.
Cập nhật 11/2026: bài viết năm 2018 được viết lại toàn bộ: thêm công thức, code đã chạy thử, thí nghiệm về batch size, phần gradient accumulation và tham số repeat khi huấn luyện LoRA.
Code và số liệu trong bài chạy với Python 3.13, NumPy 2.5, PyTorch 2.15 (CPU), Keras 3.15 (backend PyTorch) và scikit-learn 1.9.
Tóm tắt nhanh
| Thuật ngữ | Nghĩa | Ví dụ: 2.000 mẫu, batch size 32, 10 epoch |
|---|---|---|
| Batch size | Số mẫu dùng cho một lần cập nhật trọng số | 32 mẫu |
| Iteration (step) | Một lần forward, backward và cập nhật trọng số trên một batch | 63 iteration mỗi epoch |
| Epoch | Một lượt duyệt hết toàn bộ dữ liệu huấn luyện | 10 epoch = 630 iteration |
Hình dung toàn bộ dữ liệu huấn luyện là một nồi cơm. Không ai ăn cả nồi trong một miếng, nên ta xúc từng thìa:
- Batch size là lượng cơm trong một thìa.
- Iteration là một lần xúc và nuốt. Mỗi lần như vậy, mô hình “tiêu hóa” thêm một ít dữ liệu và chỉnh lại trọng số một chút.
- Epoch là lúc ăn hết cả nồi một lượt. Ăn lại nồi đó lần nữa (thường đã đảo đều), ta bước sang epoch thứ hai.
Vì sao phải chia dữ liệu thành từng batch?
Huấn luyện mạng neural là tối ưu hàm mất mát bằng gradient descent: tính gradient của loss theo trọng số rồi bước một bước ngược hướng gradient. Nếu dùng một batch $\mathcal{B}_t$ gồm $B$ mẫu, một lần cập nhật có dạng:
$$ w_{t+1} = w_t - \eta \cdot \frac{1}{B} \sum_{i \in \mathcal{B}_t} \nabla_w \ell(x_i, y_i; w_t) $$Trong đó $\eta$ là learning rate và $\ell$ là loss của từng mẫu. Tùy cách chọn $B$, ta có ba biến thể:
- Batch gradient descent ($B = N$): mỗi lần cập nhật dùng toàn bộ $N$ mẫu. Gradient chính xác nhưng tốn bộ nhớ và mỗi epoch chỉ cập nhật đúng một lần.
- Stochastic gradient descent ($B = 1$): cập nhật sau từng mẫu. Rất nhiều bước nhưng gradient nhiễu và không tận dụng được khả năng tính song song của GPU.
- Mini-batch gradient descent ($1 < B < N$): cách gần như mọi framework đang dùng. Khi PyTorch hay Keras nói “SGD”, thực chất là SGD trên mini-batch.
Chia batch giải quyết hai việc cùng lúc: dữ liệu vừa với bộ nhớ GPU, và mô hình được cập nhật nhiều lần trong một epoch thay vì chỉ một lần. Cách bước từng bước như thế nào (SGD, Momentum, Adam…) là chủ đề của bài Các thuật toán tối ưu Gradient Descent.
Epoch là gì?
Một epoch kết thúc khi mọi mẫu trong tập huấn luyện đã đi qua mô hình đúng một lần. Thông thường dữ liệu được xáo trộn lại ở đầu mỗi epoch để thứ tự các batch không lặp lại.
Một epoch hiếm khi đủ, vì mỗi lần cập nhật chỉ nhích trọng số một bước nhỏ. Khi số epoch tăng, mô hình thường đi từ underfitting (chưa học đủ), qua vùng vừa khớp, rồi sang overfitting (thuộc lòng dữ liệu huấn luyện, kém trên dữ liệu mới). Vì vậy số epoch là một siêu tham số phải chọn dựa trên tập validation, không phải “càng nhiều càng tốt”.
Batch size là gì?
Batch size là số mẫu được xử lý trước mỗi lần cập nhật trọng số. Trong Keras, batch_size mặc định là 32; trong PyTorch, DataLoader mặc định batch_size=1 nên bạn gần như luôn phải đặt giá trị này.
Batch size bị chặn trên bởi bộ nhớ GPU: ảnh lớn, mô hình lớn hoặc chuỗi văn bản dài đều làm batch tối đa nhỏ lại. Batch size cũng ảnh hưởng tới tốc độ học và chất lượng mô hình, như thí nghiệm bên dưới cho thấy.
Iteration (step) là gì?
Một iteration là một lần cập nhật trọng số trên một batch. Với $N$ mẫu và batch size $B$:
$$ \text{iteration mỗi epoch} = \left\lceil \frac{N}{B} \right\rceil $$$$ \text{tổng iteration} = \text{số epoch} \times \left\lceil \frac{N}{B} \right\rceil $$Phép làm tròn lên $\lceil \cdot \rceil$ quan trọng: khi $N$ không chia hết cho $B$, batch cuối cùng nhỏ hơn. Một số ví dụ:
| Số mẫu $N$ | Batch size $B$ | Iteration mỗi epoch | Ghi chú |
|---|---|---|---|
| 2.000 | 32 | 63 | batch cuối có 16 mẫu |
| 20.000 | 500 | 40 | chia hết |
| 50.000 (CIFAR-10) | 128 | 391 | batch cuối có 80 mẫu |
| 1.281.167 (ImageNet-1k) | 256 | 5.005 | batch cuối có 143 mẫu |
Nếu đặt drop_last=True trong PyTorch, batch thiếu ở cuối bị bỏ đi và số iteration là $\lfloor N/B \rfloor$.
Đếm iteration bằng PyTorch
Đoạn code sau tạo 2.000 mẫu giả, chia batch 32 và in ra những con số ở trên:
 1import math
 2import torch
 3from torch.utils.data import DataLoader, TensorDataset
 4
 5N, B, EPOCHS = 2000, 32, 10
 6dataset = TensorDataset(torch.randn(N, 20), torch.randint(0, 2, (N,)))
 7
 8loader = DataLoader(dataset, batch_size=B, shuffle=True)
 9print("iterations/epoch:", len(loader), "| công thức ceil(N/B):", math.ceil(N / B))
10
11sizes = [xb.shape[0] for xb, yb in loader]
12print("batch đầu:", sizes[0], "| batch cuối:", sizes[-1], "| tổng mẫu:", sum(sizes))
13
14loader_drop = DataLoader(dataset, batch_size=B, shuffle=True, drop_last=True)
15print("drop_last=True -> iterations/epoch:", len(loader_drop), "| mẫu bị bỏ mỗi epoch:", N - len(loader_drop) * B)
16
17print("tổng iteration sau", EPOCHS, "epoch:", EPOCHS * len(loader))
Kết quả (PyTorch 2.15, CPU):
1iterations/epoch: 63 | công thức ceil(N/B): 63
2batch đầu: 32 | batch cuối: 16 | tổng mẫu: 2000
3drop_last=True -> iterations/epoch: 62 | mẫu bị bỏ mỗi epoch: 16
4tổng iteration sau 10 epoch: 630
Đọc dòng log “63/63” trong Keras
Keras in số iteration của mỗi epoch ngay trong log. Đoạn code dưới chạy được với Keras 3 trên backend PyTorch, TensorFlow hoặc JAX:
 1import os
 2os.environ.setdefault("KERAS_BACKEND", "torch")  # chạy được với backend torch, tensorflow hoặc jax
 3import numpy as np
 4import keras
 5
 6keras.utils.set_random_seed(42)  # cố định seed để chạy lại ra cùng kết quả
 7N = 2000
 8x = np.random.rand(N, 20).astype("float32")
 9y = (x.sum(axis=1) > 10).astype("float32")
10
11model = keras.Sequential([
12    keras.Input(shape=(20,)),
13    keras.layers.Dense(16, activation="relu"),
14    keras.layers.Dense(1, activation="sigmoid"),
15])
16model.compile(optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"])
17history = model.fit(x, y, batch_size=32, epochs=3, verbose=2)
18print("Số lần cập nhật trọng số:", int(model.optimizer.iterations))
1Epoch 1/3
263/63 - 0s - 4ms/step - accuracy: 0.5435 - loss: 0.6926
3Epoch 2/3
463/63 - 0s - 5ms/step - accuracy: 0.5635 - loss: 0.6820
5Epoch 3/3
663/63 - 0s - 7ms/step - accuracy: 0.5765 - loss: 0.6737
7Số lần cập nhật trọng số: 189
Epoch 1/3 là epoch hiện tại trên tổng số epoch. 63/63 là số batch đã chạy trên số batch của một epoch, tức 63 iteration. Biến optimizer.iterations đếm tổng số lần cập nhật: 3 × 63 = 189. Độ chính xác ở đây không quan trọng vì nhãn chỉ là dữ liệu giả.
Thí nghiệm: cùng 20 epoch, batch size khác nhau
Để thấy batch size ảnh hưởng thế nào, mình huấn luyện cùng một mạng nhỏ (64 → 128 → 10) trên bộ chữ số viết tay digits có sẵn trong scikit-learn (1.437 ảnh huấn luyện, 360 ảnh kiểm tra), giữ nguyên 20 epoch và SGD, chỉ đổi batch size. Mỗi cấu hình chạy 3 seed rồi lấy trung bình:
 1import math, time
 2import torch
 3from torch import nn
 4from torch.utils.data import DataLoader, TensorDataset
 5from sklearn.datasets import load_digits
 6from sklearn.model_selection import train_test_split
 7
 8torch.set_num_threads(1)
 9X, y = load_digits(return_X_y=True)
10X = X / 16.0
11X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=0, stratify=y)
12X_tr, X_te = torch.tensor(X_tr, dtype=torch.float32), torch.tensor(X_te, dtype=torch.float32)
13y_tr, y_te = torch.tensor(y_tr), torch.tensor(y_te)
14
15def run(batch_size, lr, epochs=20, seed=0):
16    torch.manual_seed(seed)
17    model = nn.Sequential(nn.Linear(64, 128), nn.ReLU(), nn.Linear(128, 10))
18    opt = torch.optim.SGD(model.parameters(), lr=lr)
19    loader = DataLoader(TensorDataset(X_tr, y_tr), batch_size=batch_size, shuffle=True)
20    steps, t0 = 0, time.perf_counter()
21    for _ in range(epochs):
22        for xb, yb in loader:
23            loss = nn.functional.cross_entropy(model(xb), yb)
24            opt.zero_grad()
25            loss.backward()
26            opt.step()
27            steps += 1
28    with torch.no_grad():
29        acc = (model(X_te).argmax(1) == y_te).float().mean().item()
30    return steps, acc, time.perf_counter() - t0
31
32for bs, lr in [(8, 0.1), (32, 0.1), (128, 0.1), (512, 0.1), (512, 0.1 * 512 / 32)]:
33    res = [run(bs, lr, seed=s) for s in range(3)]
34    acc = sum(r[1] for r in res) / len(res)
35    t = sum(r[2] for r in res) / len(res)
36    print(bs, lr, math.ceil(len(X_tr) / bs), res[0][0], round(acc, 3), round(t, 2))
| Batch size | Learning rate | Iteration mỗi epoch | Tổng số lần cập nhật | Accuracy test | Thời gian (CPU, 1 luồng) |
|---|---|---|---|---|---|
| 8 | 0,1 | 180 | 3.600 | 0,975 | 2,33 s |
| 32 | 0,1 | 45 | 900 | 0,965 | 0,75 s |
| 128 | 0,1 | 12 | 240 | 0,931 | 0,37 s |
| 512 | 0,1 | 3 | 60 | 0,836 | 0,28 s |
| 512 | 1,6 (nhân 16 lần) | 3 | 60 | 0,892 | 0,23 s |
Đọc bảng này:
- Cùng số epoch, batch nhỏ cập nhật nhiều hơn. Batch 8 được cập nhật 3.600 lần, batch 512 chỉ 60 lần, nên batch 512 chưa kịp học xong (0,836).
- Batch lớn chạy mỗi epoch nhanh hơn, vì ít vòng lặp Python hơn và mỗi phép nhân ma trận lớn hơn. Trên GPU, khoảng cách này còn rõ hơn. Sách Deep Learning của Goodfellow và cộng sự cũng lưu ý rằng batch quá nhỏ không tận dụng hết phần cứng nhiều lõi.
- Tăng batch thì nên tăng learning rate. Nhân learning rate theo cùng tỉ lệ với batch size (quy tắc linear scaling trong bài báo của Goyal và cộng sự, 2017) kéo accuracy từ 0,836 lên 0,892. Nhóm tác giả còn dùng giai đoạn warmup (tăng dần learning rate ở đầu) để quy tắc này ổn định với batch hàng nghìn mẫu; thí nghiệm nhỏ ở đây không có warmup.
Đây là bộ dữ liệu rất nhỏ chạy trên CPU, nên con số tuyệt đối không mang sang bài toán khác được; xu hướng thì giống nhau.
Nên chọn batch size bao nhiêu?
Không có một con số đúng cho mọi bài toán, nhưng có vài nguyên tắc dùng được ngay:
- Bắt đầu với 32 hoặc 64. Masters và Luschi (2018) báo cáo kết quả tốt nhất ổn định với batch từ 2 đến 32 trên các thí nghiệm của họ. Keskar và cộng sự (2016) chỉ ra batch rất lớn dễ hội tụ về các điểm cực tiểu “nhọn” và tổng quát hóa kém hơn.
- Muốn huấn luyện nhanh hơn bằng batch lớn thì tăng learning rate theo batch size, thêm warmup và theo dõi validation loss.
- Không bắt buộc là lũy thừa của 2. 32, 64, 128 là thói quen để khớp phần cứng; 48 hay 96 vẫn chạy bình thường.
- Batch quá nhỏ làm BatchNorm kém ổn định, vì thống kê mean/variance tính trên quá ít mẫu. Khi đó cân nhắc LayerNorm hoặc GroupNorm (xem Các kỹ thuật chuẩn hóa trong Deep Learning).
- Thiếu bộ nhớ GPU thì dùng gradient accumulation (phần dưới) hoặc mixed precision thay vì ép batch xuống 1–2.
Nên chọn bao nhiêu epoch?
Số epoch phụ thuộc vào kích thước dữ liệu, độ lớn mô hình và lịch learning rate, nên cách thực tế là để dữ liệu quyết định:
- Vẽ đường loss của tập train và tập validation theo từng epoch. Khi validation loss ngừng giảm rồi tăng lên trong khi train loss vẫn giảm, mô hình bắt đầu overfit.
- Dùng early stopping: dừng khi validation loss không cải thiện sau một số epoch (gọi là patience) và giữ lại trọng số tốt nhất. Keras có sẵn callback
keras.callbacks.EarlyStopping; trong PyTorch bạn tự viết vài dòng hoặc dùng callback của Lightning. - Fine-tune một mô hình đã huấn luyện sẵn thường chỉ cần vài epoch; huấn luyện từ đầu cần nhiều hơn hẳn.
Gradient accumulation: batch lớn trên GPU nhỏ
Khi GPU chỉ chứa được batch 8 mà bạn muốn hành vi gần với batch 32, có thể cộng dồn gradient qua 4 mini-batch rồi mới cập nhật trọng số một lần:
 1import torch
 2from torch import nn
 3from torch.utils.data import DataLoader, TensorDataset
 4
 5torch.manual_seed(0)
 6data = TensorDataset(torch.randn(2000, 20), torch.randint(0, 2, (2000,)))
 7loader = DataLoader(data, batch_size=8, shuffle=True)
 8
 9model = nn.Sequential(nn.Linear(20, 16), nn.ReLU(), nn.Linear(16, 2))
10optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
11accum_steps = 4
12
13optimizer_steps = 0
14optimizer.zero_grad()
15for i, (xb, yb) in enumerate(loader, start=1):
16    loss = nn.functional.cross_entropy(model(xb), yb) / accum_steps  # chia để gradient là trung bình
17    loss.backward()                                                 # gradient được CỘNG DỒN vào .grad
18    if i % accum_steps == 0 or i == len(loader):
19        optimizer.step()
20        optimizer.zero_grad()
21        optimizer_steps += 1
22
23print("mini-batch đã chạy (forward/backward):", len(loader))
24print("số lần cập nhật trọng số (optimizer step):", optimizer_steps)
1mini-batch đã chạy (forward/backward): 250
2số lần cập nhật trọng số (optimizer step): 63
Lúc này “iteration” theo nghĩa cập nhật trọng số chỉ còn 63 mỗi epoch, dù có 250 lần forward/backward. Batch hiệu dụng được tính như sau:
$$ B_{\text{hiệu dụng}} = B_{\text{mỗi GPU}} \times \text{số bước cộng dồn} \times \text{số GPU} $$Hugging Face Trainer dùng đúng hai tham số per_device_train_batch_size và gradient_accumulation_steps, và con số step trong log của nó là số lần optimizer cập nhật, không phải số mini-batch. Tài liệu của Hugging Face cũng lưu ý gradient accumulation chỉ giúp vừa bộ nhớ, không làm huấn luyện nhanh hơn một batch lớn thật.
Repeat khi train LoRA (Stable Diffusion, Flux) là gì?
Khi huấn luyện LoRA bằng bộ công cụ kohya-ss, bạn sẽ gặp thêm tham số repeat (num_repeats trong file cấu hình, hoặc tiền tố số trong tên thư mục như 10_tenconcept). Repeat là số lần mỗi ảnh được lặp lại trong một epoch. Vì vậy số step mỗi epoch xấp xỉ:
Ví dụ 20 ảnh, repeat 10, batch size 2 cho khoảng 100 step mỗi epoch; 10 epoch là khoảng 1.000 step. Con số thực tế có thể nhỉnh hơn một chút khi bật chia nhóm ảnh theo kích thước (bucketing).
Repeat thường được dùng để:
- Cân bằng với ảnh regularization (ảnh cùng lớp với đối tượng, ví dụ ảnh “người” bất kỳ khi train một người cụ thể). Ý tưởng này đến từ prior preservation loss của DreamBooth: giữ cho mô hình không quên lớp chung trong lúc học đối tượng mới.
- Đặt trọng số cho từng nhóm ảnh: nhóm ảnh chất lượng cao có repeat lớn hơn để mô hình học từ chúng nhiều hơn.
Những nhầm lẫn thường gặp
- Coi epoch và iteration là một. Một epoch gồm nhiều iteration; chỉ khi batch size bằng toàn bộ dữ liệu thì hai con số mới trùng nhau.
- Nhầm step với mini-batch. Khi có gradient accumulation, số step (optimizer step) nhỏ hơn số mini-batch.
- Nhầm batch mỗi GPU với batch tổng. Huấn luyện trên 4 GPU, mỗi GPU batch 16, thì mỗi lần cập nhật thực chất dùng 64 mẫu.
- Quên batch cuối bị thiếu. Số iteration là làm tròn lên; với
drop_last=Truethì làm tròn xuống. - Đổi batch size mà giữ nguyên learning rate. Như thí nghiệm ở trên, batch tăng 16 lần mà learning rate giữ nguyên thì mô hình học chậm hẳn.
- Tăng epoch để “học cho kỹ”. Quá nhiều epoch dẫn tới overfitting; hãy theo dõi validation loss.
Câu hỏi thường gặp
1 epoch là gì? Là một lượt mô hình duyệt hết toàn bộ dữ liệu huấn luyện, mỗi mẫu đúng một lần.
Batch size bao nhiêu là tốt? Bắt đầu với 32 hoặc 64, tăng nếu GPU còn trống và cần huấn luyện nhanh hơn (kèm tăng learning rate), giảm nếu hết bộ nhớ hoặc kết quả validation kém đi.
Epoch càng nhiều càng tốt không? Không. Sau một số epoch nhất định, mô hình bắt đầu overfit. Dùng early stopping trên tập validation để dừng đúng lúc.
Iteration và step có khác nhau không? Thường là một: một lần cập nhật trọng số. Ngoại lệ là khi dùng gradient accumulation, lúc đó step là số lần optimizer cập nhật, còn số mini-batch thì nhiều hơn.
Batch size có ảnh hưởng đến độ chính xác không? Có. Batch size thay đổi số lần cập nhật mỗi epoch và độ nhiễu của gradient, nên ảnh hưởng tới cả tốc độ hội tụ lẫn khả năng tổng quát hóa.
Đọc thêm trên blog
- Toàn bộ chủ đề: Nền tảng Machine Learning & Deep Learning
- Các thuật toán tối ưu Gradient Descent: SGD, Momentum, RMSprop, Adam, AdamW
- Dropout là gì? Cách Dropout chống overfitting trong Deep Learning
- Các kỹ thuật chuẩn hóa trong Deep Learning
- Một số mẹo khi huấn luyện mạng deep neural network
- Các lý do khiến mạng neural network không hoạt động
Tài liệu tham khảo
- Ian Goodfellow, Yoshua Bengio, Aaron Courville. Deep Learning, Chương 8: Optimization for Training Deep Models. deeplearningbook.org
- Nitish Shirish Keskar và cộng sự (2016). On Large-Batch Training for Deep Learning: Generalization Gap and Sharp Minima. arXiv:1609.04836
- Priya Goyal và cộng sự (2017). Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour. arXiv:1706.02677
- Dominic Masters, Carlo Luschi (2018). Revisiting Small Batch Training for Deep Neural Networks. arXiv:1804.07612
- PyTorch. torch.utils.data (DataLoader). docs.pytorch.org
- Keras. Model training APIs (fit, batch_size, epochs, steps_per_epoch). keras.io
- Hugging Face. Gradient accumulation. huggingface.co
- kohya-ss/sd-scripts. Dataset config (num_repeats). github.com
- Nataniel Ruiz và cộng sự (2022). DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation. arXiv:2208.12242
Bình luận